Мобильный, приватный, умный искусственный интеллект без цензуры, без интернета в твоей сумке.
Можно ли получить все это за вменяемые деньги, точнее до 2000 USD? Ответ: да, я протестировал, и это работает. Коротко, в нескольких словах, без воды:
Игровая приставка: Lenovo Legion Go 2 Extreme (8ASP2), 32 GB RAM (с возможностью выделить 24 GB RAM под GPU) + gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf 15.6 GB (16,796,011,680 bytes) в редакции Heretic ~24 токена в секунду
В принципе, на этом можно и закончить, но на этот раз сделаю исключение и напишу более подробную статью. Все нижеописанное является моим субъективным мнением; если есть решение лучше — можете мне о нем написать.
Есть задача: получить мобильный, персональный, приватный и главное — умный искусственный интеллект без цензуры, не зависящий от интернета, в качестве персонального ИИ-ассистента, в гуманном бюджете с учетом текущих цен на оперативную память.
Модели на 3–6–9–12B мне не интересны:
По моему личному мнению, эти модели хороши как чат-боты, но не как умные компаньоны.
Для меня интеллект начинается с 26–32 миллиардов параметров.
Даже при разделении на экспертов в MOE ~ по 4B параметров , 26B MOE умнее и глубже, чем 12B. + MOE модель меньше подвержена глюцинациям + прирост производительности очень существенный.
Ближайшее интересное решение — очень компактный ноутбук GPD Win Mini (2025) AMD AI 370, 32 GB / 2 TB + есть встроенный NPU-чип, способный потенциально взять на себя обработку распознавания и генерации речи. Но меня остановили следующие нюансы:
-
нет подтверждения информации о возможности выделить под GPU больше 16 GB RAM из-за особенностей BIOS;
-
стоимость доставки из-за границы с рисками повреждений, отсутствие гарантии и трудности с возвратом;
-
окончательная стоимость у меня в стране — 2400 USD
Я нашел более изящное решение: Lenovo Legion Go 2 Extreme, 32 GB RAM, гарантированная возможность выделить 24 GB под GPU, соответственно — больше места под кэш и контекстное окно, более умные модели с нормальным квантованием без сильной потери качества. Если бы у меня не пошел ИИ, я всегда получаю игрушку для AAA-проектов + 3 года гарантии. Итого цена решения — 1900 USD.
вот результаты моих тестов :
настройки modefile:
# Указываем базовую GGUF-модель (путь может быть абсолютным или относительным, где лежит файл)
FROM ./gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf

# Твои параметры
PARAMETER num_ctx 8192
PARAMETER flash_attention true
PARAMETER temperature 0.7
PARAMETER top_p 0.9
PARAMETER repeat_penalty 1.1

# Шаблон чата для корректной работы Gemma (в стиле ChatML / Gemma)
TEMPLATE """{{ if .System }}{{ .System }}{{ end }}{{ if .Prompt }}<start_of_turn>user
{{ .Prompt }}<end_of_turn>
{{ end }}<start_of_turn>model
{{ .Response }}<end_of_turn>"""

# Системный промпт по умолчанию (при необходимости можешь изменить)
SYSTEM """You are a helpful, respectful, and honest assistant."""
(Окно контента целенаправлено урезанно до 8192 чтобы не терять скорость и иметь резерв памяти)
конфигурация: 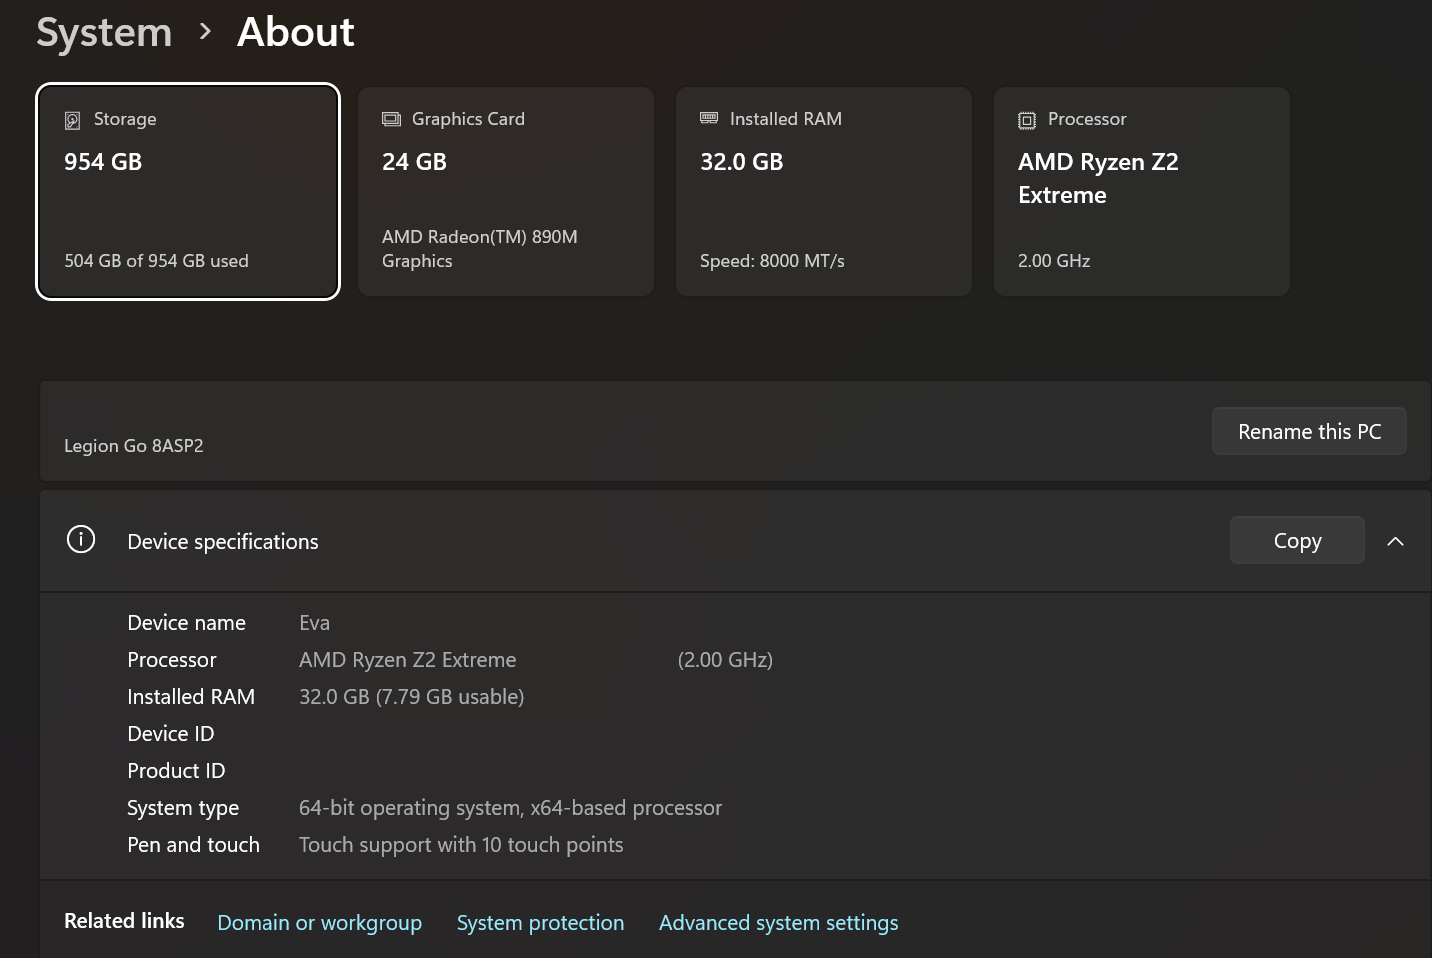
Без нагрузки:
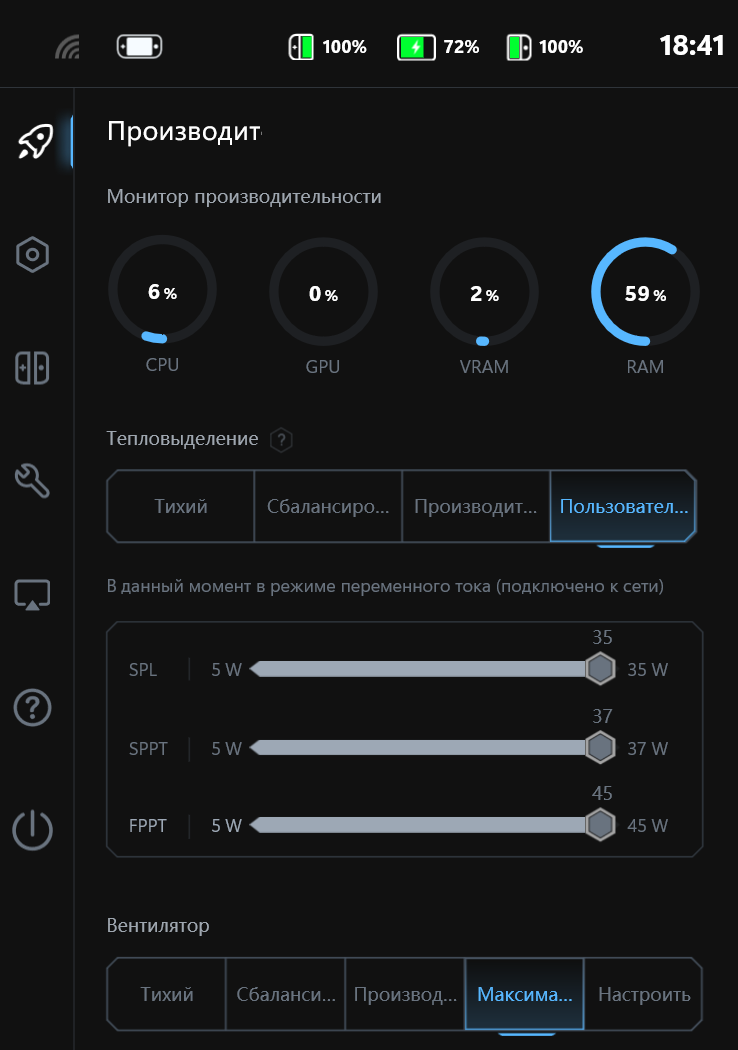
В момент рассуждений:
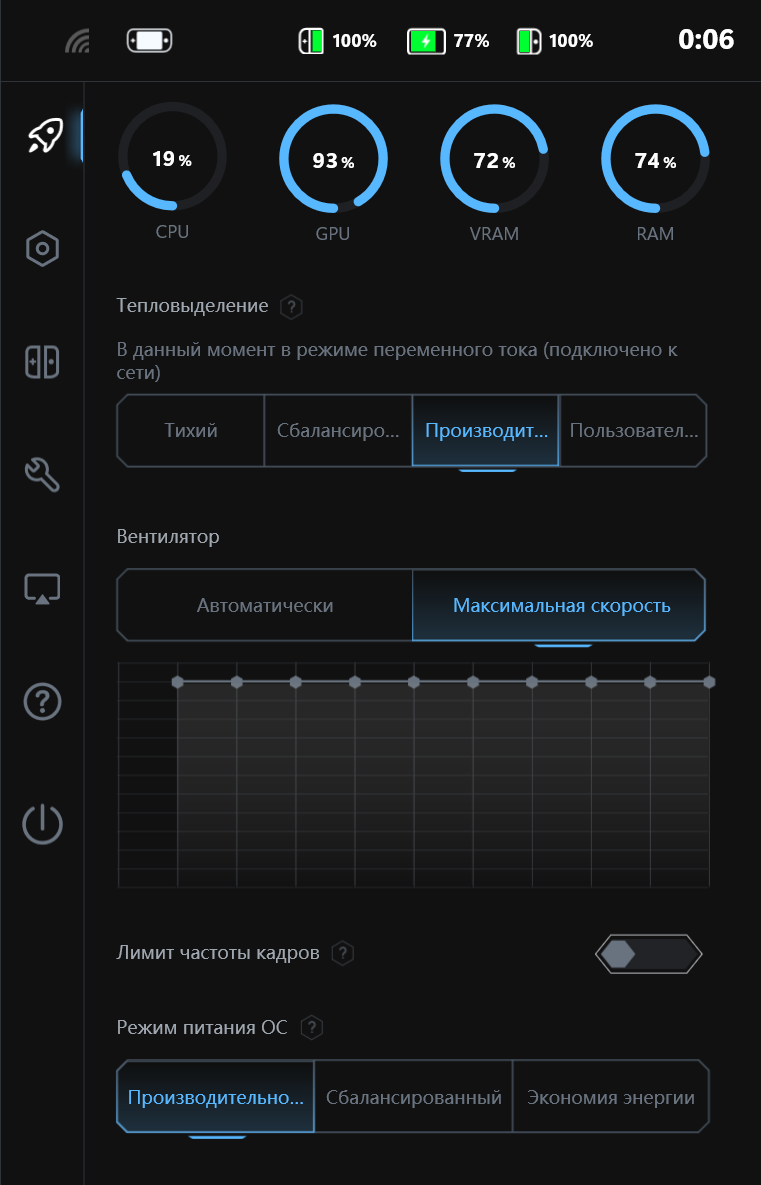
тесты и результаты:
ollama run gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи про Лос-Анджелес» —verbose
total duration: 1m23.0339404s
load duration: 15.170647s
prompt eval count: 26 token(s)
prompt eval duration: 322.618ms
prompt eval rate: 80.59 tokens/s
eval count: 1649 token(s)
eval duration: 1m7.527462s
eval rate: 24.42 tokens/s
ollama run gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи Нью-Йорк» —verbose
total duration: 1m25.8860327s
load duration: 14.877167s
prompt eval count: 23 token(s)
prompt eval duration: 330.67ms
prompt eval rate: 69.56 tokens/s
eval count: 1730 token(s)
eval duration: 1m10.67053s
eval rate: 24.48 tokens/s
ollama run gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи про Сан-Франциско» —verbose
total duration: 1m21.1723763s
load duration: 14.3842813s
prompt eval count: 25 token(s)
prompt eval duration: 356.556ms
prompt eval rate: 70.12 tokens/s
eval count: 1630 token(s)
eval duration: 1m6.398297s
eval rate: 24.55 tokens/s
на сколько 24 токена это быстро, можно посмотреть в этом ролике, но важный момент — скорость просела на ~1 токен из-за записи экрана, т.к выросла нагрузка на GPU (я записывал несколько дублей видео, каждый раз был тот же результат — без включенной записи ~24 при включенной ~23 токена в секунду)
Для чистоты эксперимента, Ollama была выгружена из памяти и запуск производился с нуля
если средняя скорость чтения человеком 4-6 токенов в секунду, то 24 токена это комфортный вывод информации, при подключении WebUI скорость просядет еще ~ до 20 токенов в секунду, перспективность использования этого интерфейса продолжаю изучать, но пока он мне не нравится, по ощущениям — комфорт, отклик и скорость.
а вот с плотными моделями совсем другая история:
gemma-4-12B-it-heretic-Q4_K_M — 6.87 GB (7,381,381,760 bytes) — 10,8 токенов в секунду
Test:
ollama run gemma-4-12-q4_k_m:latest «расскажи про Лос-Анджелес» —verbose
total duration: 2m31.254414s
load duration: 9.5004932s
prompt eval count: 26 token(s)
prompt eval duration: 373.181ms
prompt eval rate: 69.67 tokens/s
eval count: 1532 token(s)
eval duration: 2m21.366823s
eval rate: 10.84 tokens/s
ollama run gemma-4-12-q4_k_m:latest «расскажи про Нью-Йорк» —verbose
total duration: 2m48.869715s
load duration: 8.9020887s
prompt eval count: 24 token(s)
prompt eval duration: 379.76ms
prompt eval rate: 63.20 tokens/s
eval count: 1725 token(s)
eval duration: 2m39.574522s
eval rate: 10.81 tokens/s
ollama run gemma-4-12-q4_k_m:latest «расскажи про Сан-Франциско» —verbose
total duration: 2m35.6647302s
load duration: 8.5794998s
prompt eval count: 25 token(s)
prompt eval duration: 358.514ms
prompt eval rate: 69.73 tokens/s
eval count: 1587 token(s)
eval duration: 2m26.717725s
eval rate: 10.82 tokens/s
Более четкая по размышлениям модель, с меньшим сжатием gemma4-12B-q8-clean — 11.7 GB (12,669,645,440 bytes) — всего 6,8 токенов в секунду
ollama run gemma-4-12b-q8-clean:latest «расскажи про Лос-Анджелес» —verbose
total duration: 4m6.0714634s
load duration: 12.6505637s
prompt eval count: 26 token(s)
prompt eval duration: 684.62ms
prompt eval rate: 37.98 tokens/s
eval count: 1597 token(s)
eval duration: 3m52.728304s
eval rate: 6.86 tokens/s
ollama run gemma-4-12b-q8-clean:latest «расскажи про Нью-Йорк» —verbose
total duration: 3m44.4679233s
load duration: 12.6456274s
prompt eval count: 24 token(s)
prompt eval duration: 676.542ms
prompt eval rate: 35.47 tokens/s
eval count: 1455 token(s)
eval duration: 3m31.137135s
eval rate: 6.89 tokens/s
ollama run gemma-4-12b-q8-clean:latest «расскажи про Сан-Франциско» —verbose
total duration: 4m21.9274252s
load duration: 12.8964248s
prompt eval count: 25 token(s)
prompt eval duration: 675.425ms
prompt eval rate: 37.01 tokens/s
eval count: 1708 token(s)
eval duration: 4m8.342528s
eval rate: 6.88 tokens/s
Вывод: плотная 12B модель прогоняет все свои веса за один токен, а 26MOE использует только часть нужных экспертов, поэтому более объемная и более умная модель 26MOE работает быстрее.
двигаемся дальше ….
Гипотеза возможность голосового общения —> предполагается, что скорость генерации текста в 4–5 раз выше скорости (на MOE модели) с которой его может озвучить движок синтеза речи вроде Piper TTS
Но это не точно, эксперименты продолжаю……