Мобильный, приватный, умный искусственный интеллект без цензуры, без интернета в твоей сумке — часть 4

Продолжаю эксперименты с Legion Go 2 Extreme (8ASP2), 32 GB RAM в качестве мобильного, приватного, умного искусственного интеллекта без цензуры.

Режим 16 GB ОЗУ + 16 GB GPU

первая часть

вторая часть

третья часть

Условия самого теста не изменились, но обновилась Ollama — теперь она более требовательна к ключам запуска.

Режим 16+16 GB RAM
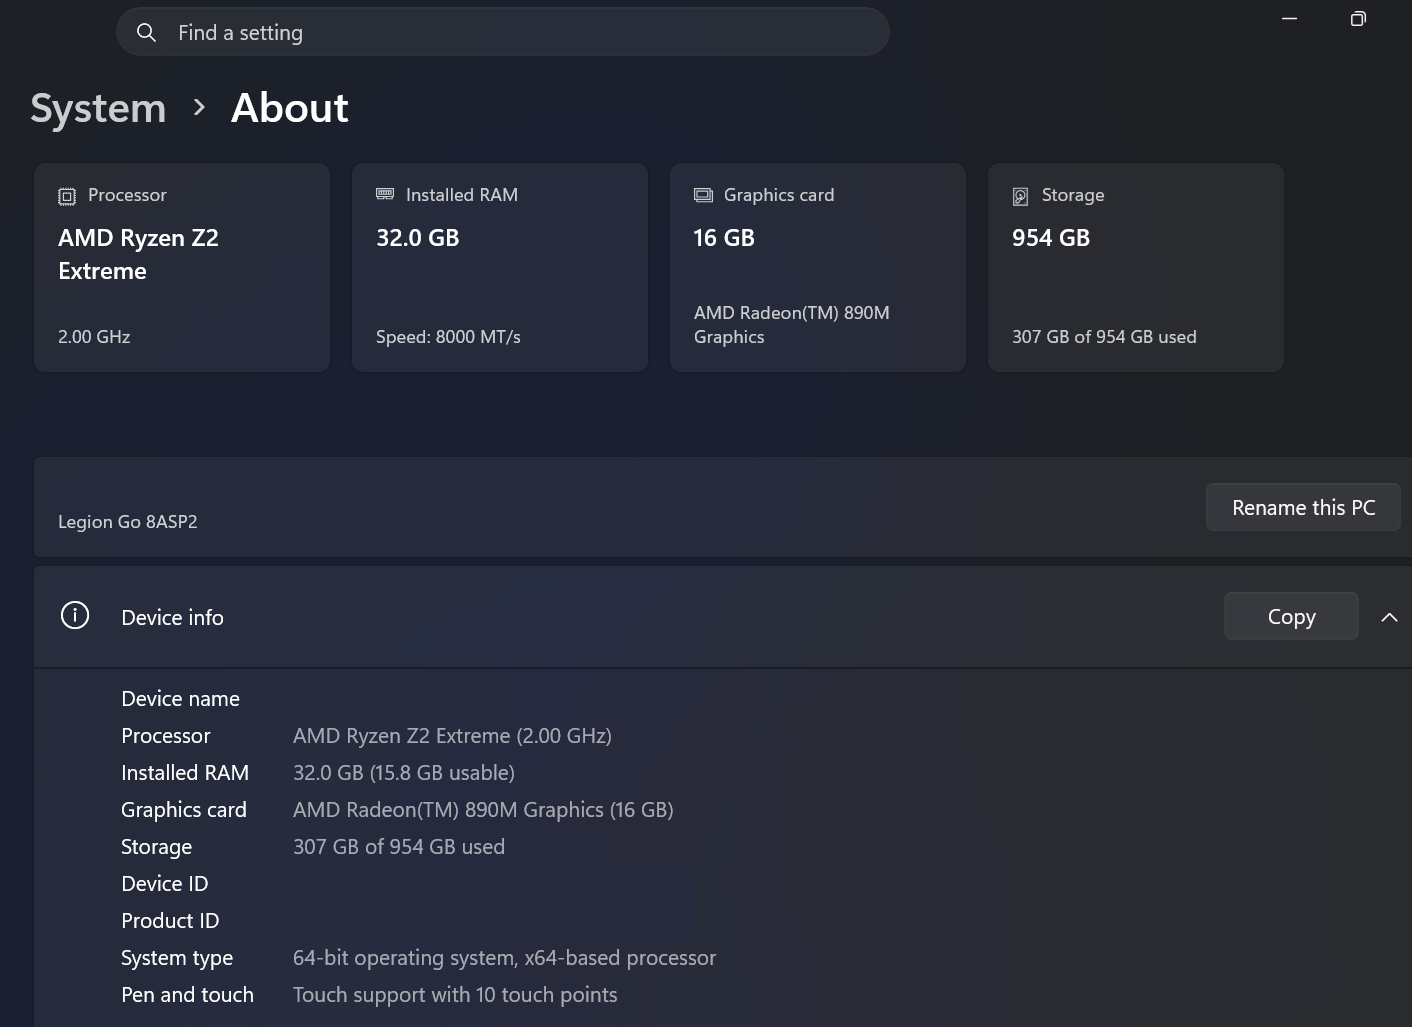

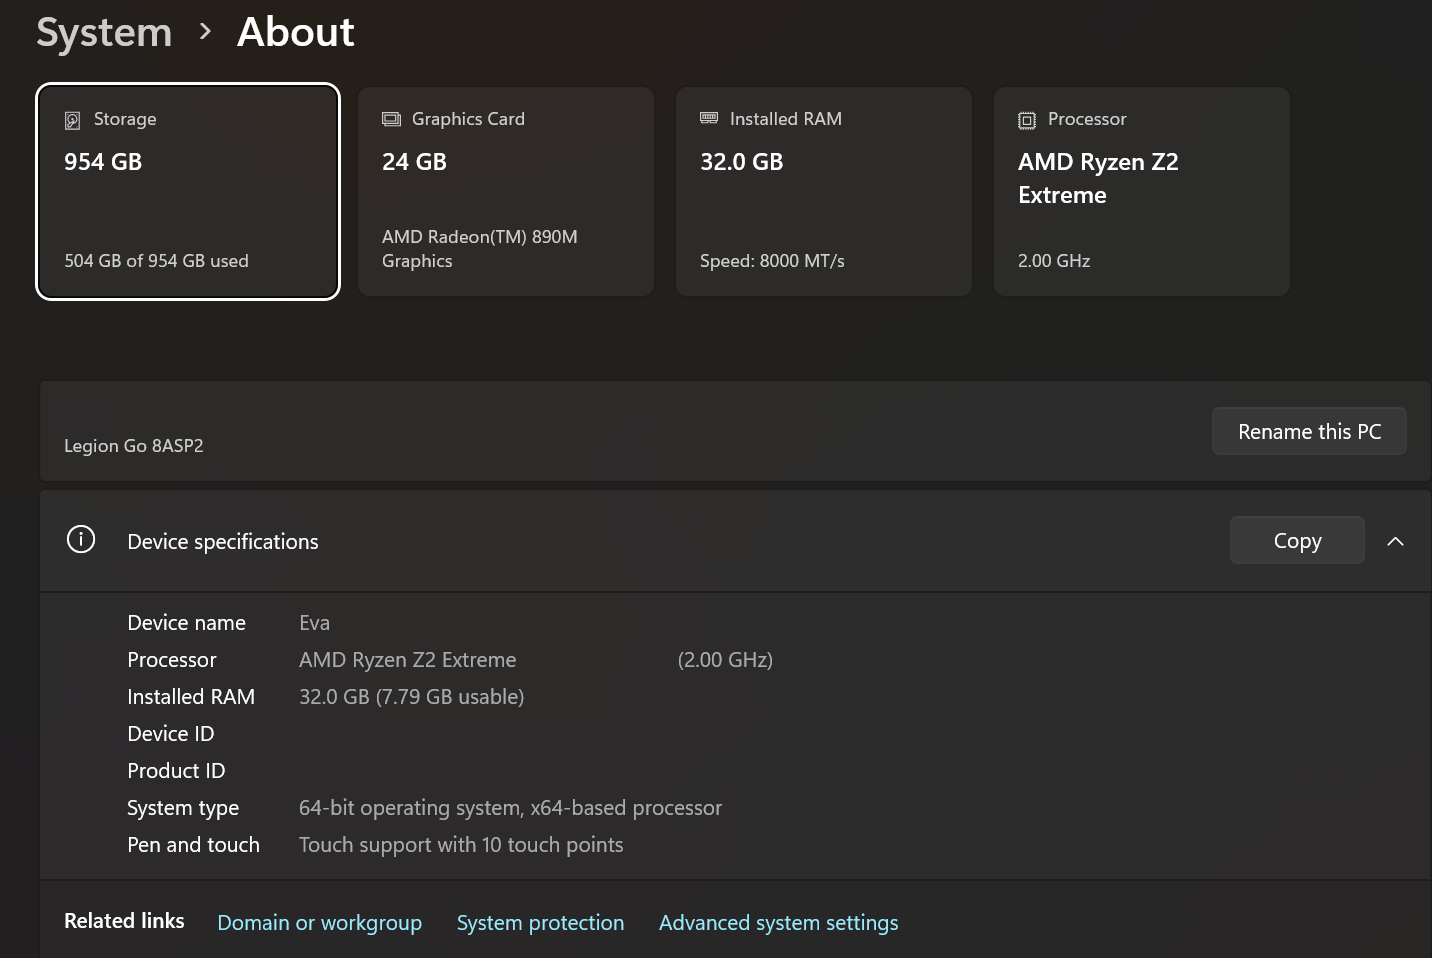
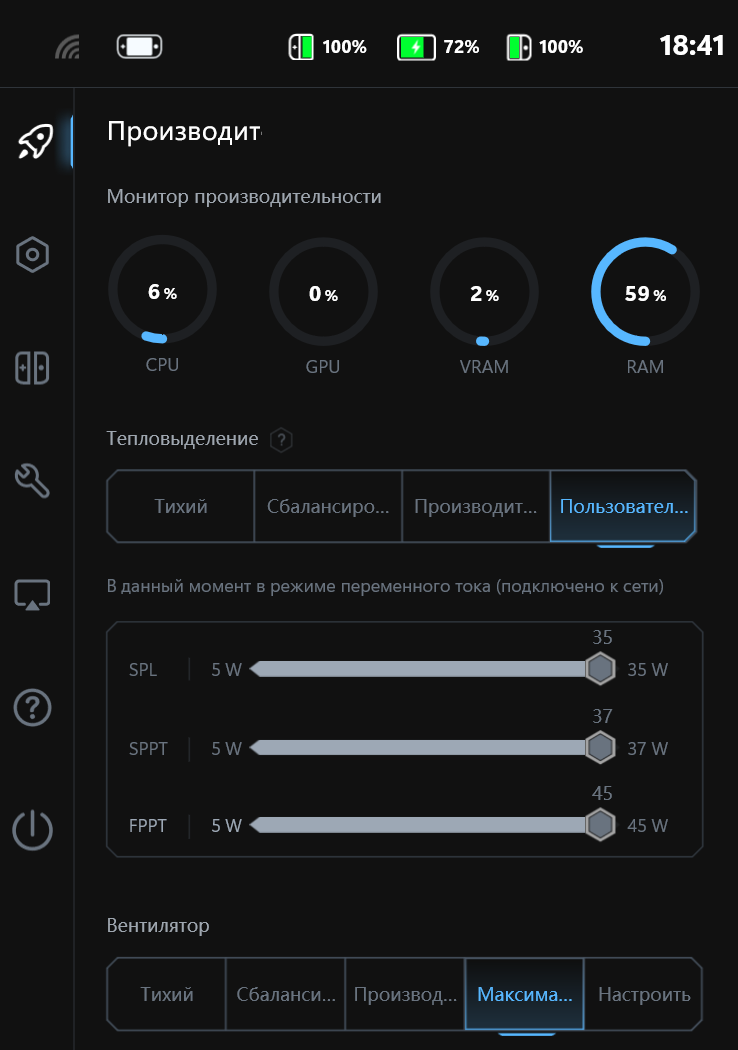
Система в режиме ожидания:

т.к. модель не помещается сейчас полностью в GPU, дополнительные приложения, кроме Notepad, выгружены из памяти.
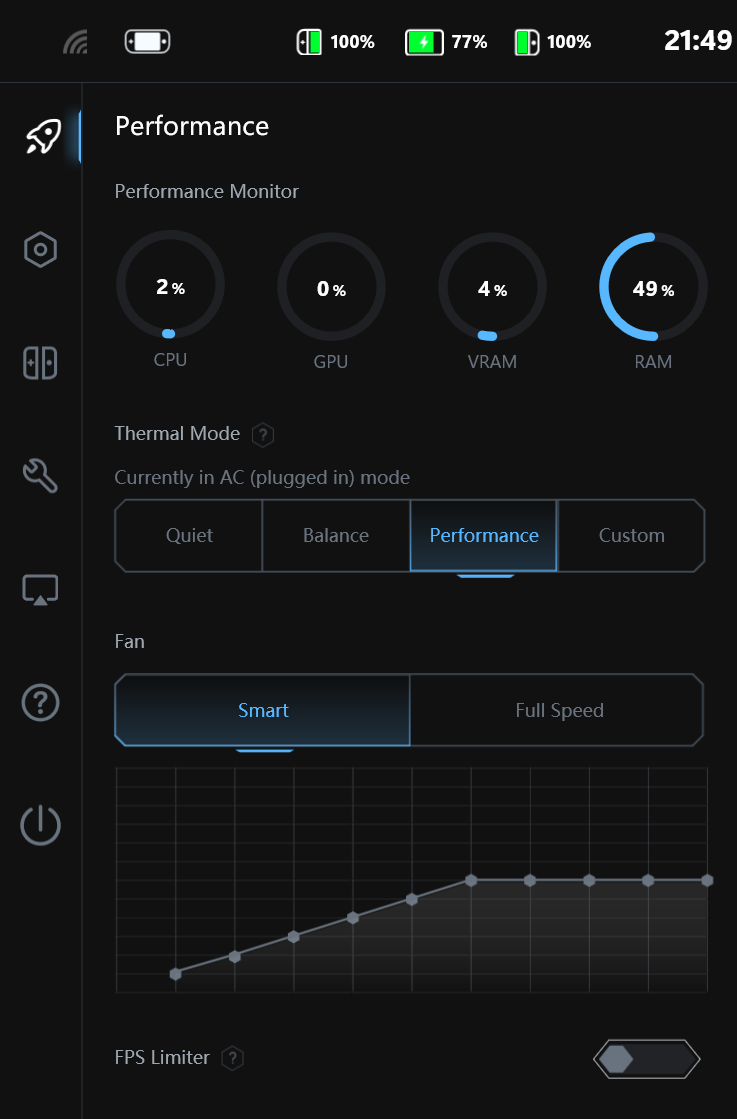
Gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf 15.6 GB (16,796,011,680 bytes)

Modefile:

# Указываем базовую GGUF-модель (путь может быть абсолютным или относительным, где лежит файл)
FROM ./gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf

# Твои параметры
PARAMETER num_ctx 8192
PARAMETER flash_attention true
PARAMETER temperature 0.7
PARAMETER top_p 0.9
PARAMETER repeat_penalty 1.1

# Шаблон чата для корректной работы Gemma (в стиле ChatML / Gemma)
TEMPLATE """{{ if .System }}{{ .System }}{{ end }}{{ if .Prompt }}user
{{ .Prompt }}
{{ end }}model
{{ .Response }}"""

# Системный промпт по умолчанию (при необходимости можешь изменить)
SYSTEM """You are a helpful, respectful, and honest assistant."""

Режим thinking не получается отключить на уровне Ollama.

Тест:

ollama run —verbose gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи про Лос-Анджелес»

total duration: 1m43.6769527s
load duration: 16.4091987s
prompt eval count: 28 token(s)
prompt eval duration: 354.333ms
prompt eval rate: 79.02 tokens/s
eval count: 1659 token(s)
eval duration: 1m26.902626s
eval rate: 19.09 tokens/s

ollama run —verbose gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи Нью-Йорк»

total duration: 1m52.1386793s
load duration: 15.6352939s
prompt eval count: 25 token(s)
prompt eval duration: 302.903ms
prompt eval rate: 82.53 tokens/s
eval count: 1805 token(s)
eval duration: 1m36.189017s
eval rate: 18.77 tokens/s

ollama run —verbose gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи про Сан-Франциско»

total duration: 1m49.557638s
load duration: 15.6424668s
prompt eval count: 27 token(s)
prompt eval duration: 311.346ms
prompt eval rate: 86.72 tokens/s
eval count: 1779 token(s)
eval duration: 1m33.592024s
eval rate: 19.01 tokens/s

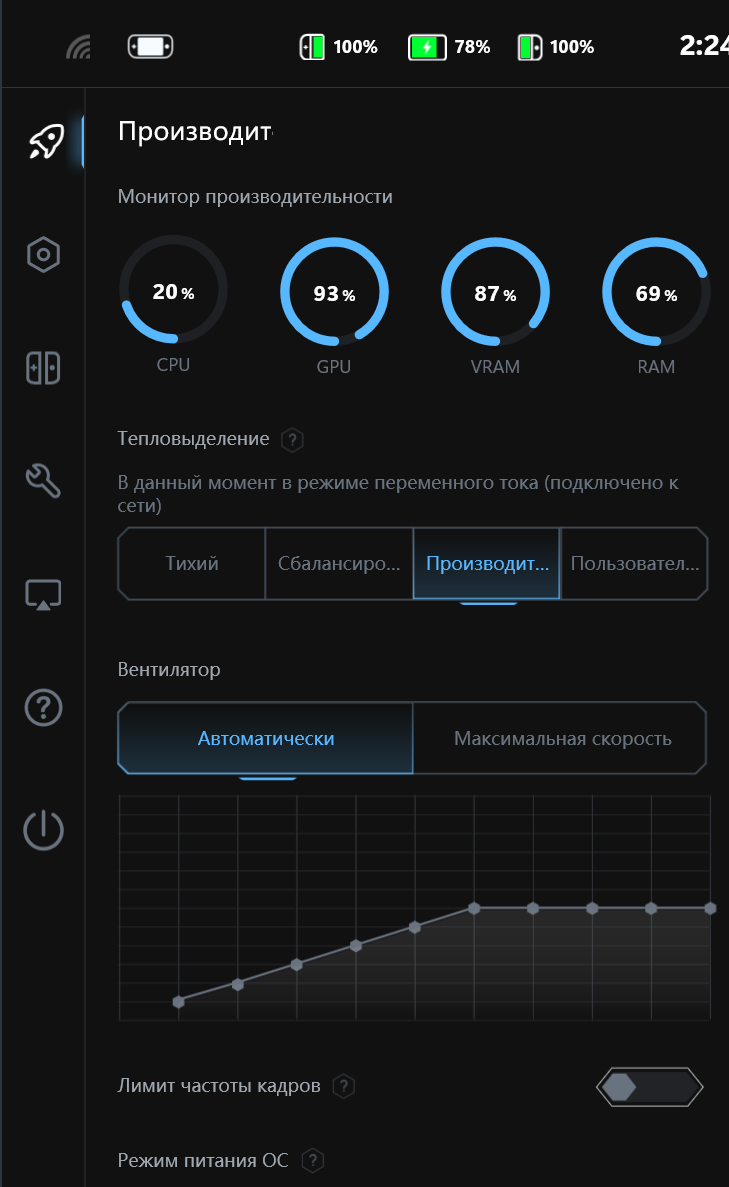
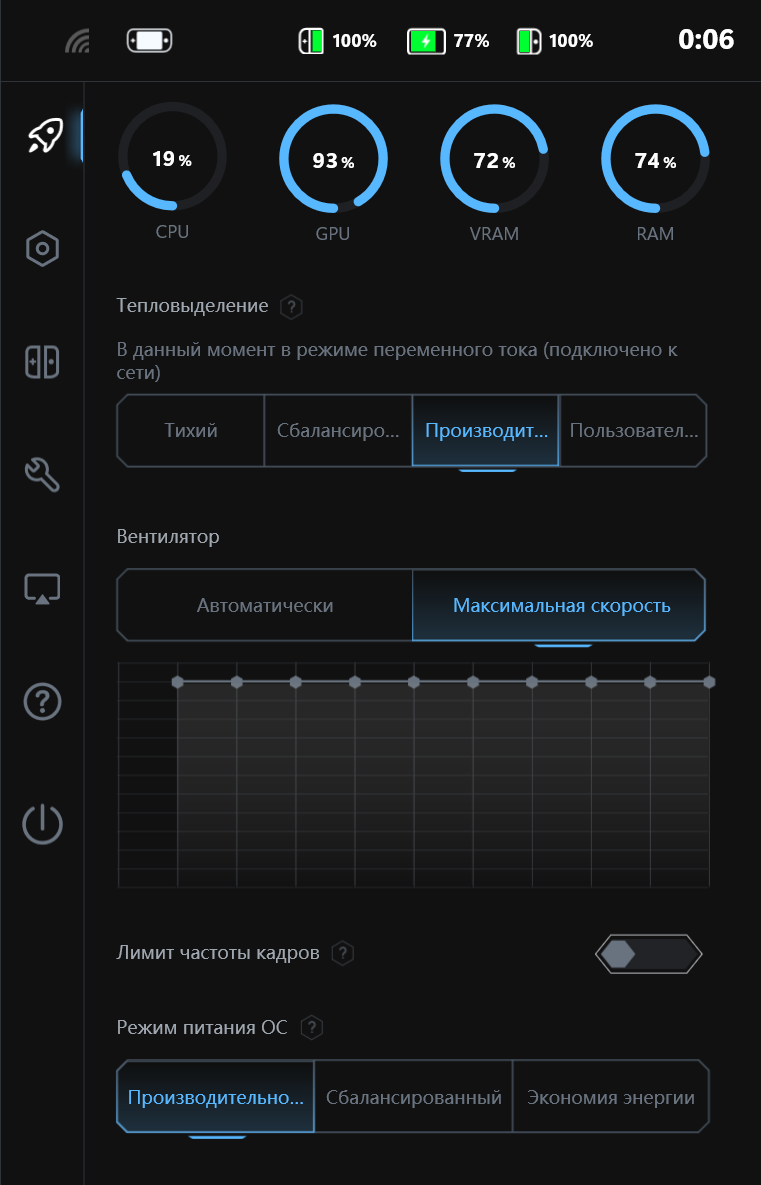
Нагрузка на систему:
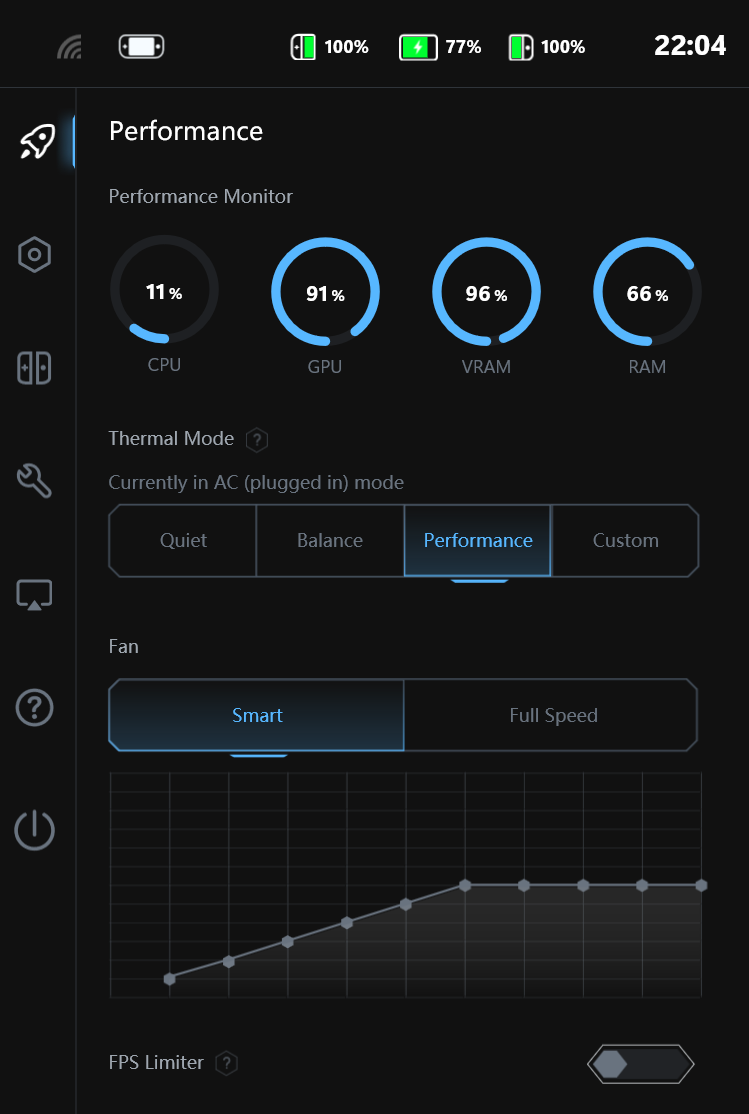
Результат 18–19 токенов за счет офлоуда против 24 токенов на 24 GB RAM: мы потеряли 5–6 токенов, но 18–19 токенов все равно остаются комфортным режимом для общения.

Переходим к тесту Qwen3-30B-A3B

Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf 17.2 GB (18,556,685,440 bytes)

Modefile:

FROM ./Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf
# Полная разгрузка на GPU
PARAMETER num_gpu 99
# Безопасный размер контекста для предотвращения переполнения
PARAMETER num_ctx 8192
# Ограничение числа потоков CPU (предотвращает ошибку thread constructor failed)
PARAMETER num_thread 4
# Параметры генерации
PARAMETER temperature 0.7
PARAMETER top_p 0.8
PARAMETER top_k 20
PARAMETER min_p 0.0
PARAMETER presence_penalty 0.0
PARAMETER repeat_penalty 1.05
TEMPLATE """{{ if .System }}<|im_start|>system
{{ .System }}<|im_end|>
{{ end }}{{ if .Prompt }}<|im_start|>user
{{ .Prompt }}<|im_end|>
{{ end }}<|im_start|>assistant
{{ .Response }}<|im_end|>
"""
SYSTEM """You are a helpful, respectful, and honest assistant."""

Режим thinking отключен.

Ollama run —verbose Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Лос-Анджелес»

total duration: 1m16.5946761s
load duration: 16.3385718s
prompt eval count: 23 token(s)
prompt eval duration: 263.35ms
prompt eval rate: 87.34 tokens/s
eval count: 1523 token(s)
eval duration: 59.980869s
eval rate: 25.39 tokens/s

ollama run —verbose Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Нью-Йорк»
total duration: 1m9.9386374s
load duration: 16.1066431s
prompt eval count: 21 token(s)
prompt eval duration: 232.669ms
prompt eval rate: 90.26 tokens/s
eval count: 1338 token(s)
eval duration: 53.591474s
eval rate: 24.97 tokens/s

ollama run —verbose Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Сан-Франциско»

total duration: 1m17.2677307s
load duration: 15.8550492s
prompt eval count: 22 token(s)
prompt eval duration: 250.865ms
prompt eval rate: 87.70 tokens/s
eval count: 1504 token(s)
eval duration: 1m1.156034s
eval rate: 24.59 tokens/s

Нагрузка на систему:
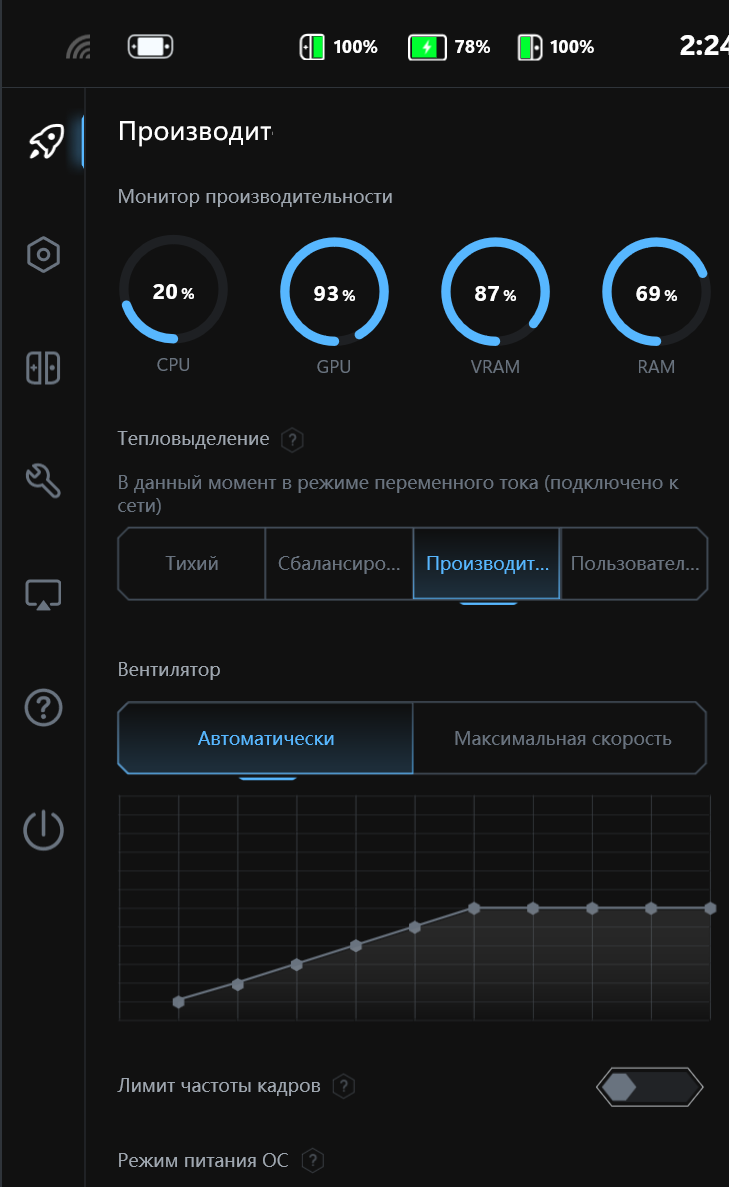
Результат 24–25 токенов против 34 токенов на 24 GB RAM, потери 9–10 токенов на офлоуде, но стабильность системы, а точнее самой Windows, значительно выросла, ощущения тормозов больше нет.

Нагрузка на GPU-память у Qwen3-30B-A3B меньше, чем у Gemma-4-26B-A4B, т. к. у Qwen 3,3 млрд активных параметров на один токен против 3,8–4 млрд у Gemma 4.

Боевой тест, применение в реальности

Переходим на Unsloth — здесь все гораздо интереснее.

Условия: все приложения, кроме Unsloth и Notepad, выгружены.

Окно контекста — 8192 токена, режим thinking выключен.

Gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf 15.6 GB (16,796,011,680 bytes)

Каждый запрос — в новом окне чата.

Надо отметить, что ответы в Unsloth стали короче, но при этом я отмечаю поразительно низкий разброс результатов: в среднем 22 токена против 24 на живой Ollama с 24 GB GPU RAM.
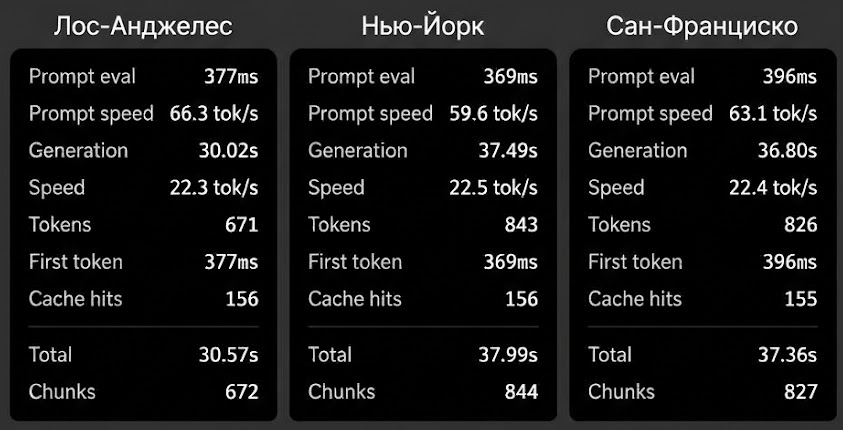
Следующий тест:

Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf 17.2 GB (18,556,685,440 bytes)

Каждый запрос — в новом окне чата.
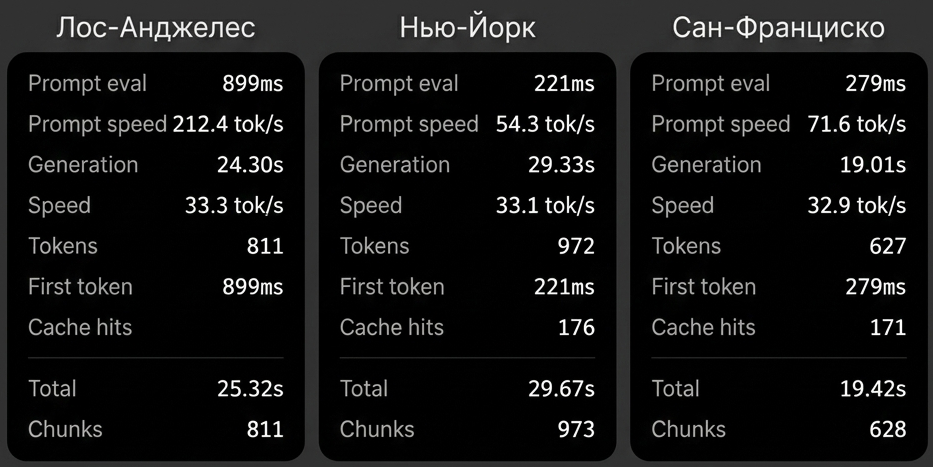
Здесь результат 32–33 токена против 34 на Ollama с 24 GB GPU RAM.

Мой вывод: режим 16 + 16 GB позволяет комфортно запускать тяжелые MoE-модели Gemma-4-26B-A4B и Qwen3-30B-A3B на Legion Go 2 Extreme (8ASP2), 32 GB RAM с офлоудом в ОЗУ. Стабильность операционной системы Windows 11 при работе с моделями в режиме 16 GB ОЗУ намного лучше, чем в режиме 24 GB GPU + 8 GB ОЗУ. Unsloth — очень интересная оболочка.

Остается открытым вопрос с голосовой озвучкой: встроенные голоса Microsoft ужасны, Piper дает результат лучше, но все равно режет слух.

На хороший голос нужно выделить независимую голосовую ИИ-модель, но здесь начинается драка между моделями за память в GPU. На ОЗУ, даже если ее удастся втиснуть между системой и офлоудом модели, скорость будет ужасная.

В режиме 16+16 свободной памяти GPU практически нет, рисковать буфером и менять мозги на голос я точно не буду. В режиме 8+24 можно, конечно, будет попробовать, но пока моя конфигурация:

Gemma-4-26B-A4B — основная модель + Qwen3-30B-A3B как  второе мнение , остается без голоса
первая часть

вторая часть

третья часть

Мобильный, приватный, умный искусственный интеллект без цензуры, без интернета в твоей сумке — часть 3

Продолжаю изыскания по оптимизации Legion Go 2 Extreme (8ASP2), 32 GB RAM в качестве мобильного, приватного, умного искусственного интеллекта без цензуры. 

первая часть

вторая часть

четвертая часть

   По моему личному мнению, Gemma 4 — 26B MOE — это одна из лучших моделей для локального ИИ на октябрь 2026 в качестве универсального ассистента.

Основная проблема Gemma 4 — это встроенный режим предварительных размышлений, который мне никак не удавалось отключить промтами на уровне Ollama и ухищрениями на Open WebUI.

Мне удалось решить эту проблему, сменив движок на Unsloth. Это очень интересная оболочка-комбайн все в одном: прямая работа на глубоком уровне с ИИ-моделью, и это не надстройка над Ollama, как WebUI.

Стабильность на очень высоком уровне, легкий автоматический сброс окна контекста, полноценный встроенный поиск в интернете, инструменты с Python, своя песочница, возможность подключить MCP Servers, работа с разными моделями, предназначенными для работы не только с текстом, но и с графикой, а также с аудио — все в одном. Ну и главная ее функция — дообучение моделей.

Этот инструмент мне очень понравился, и я решил перейти на эту инфраструктуру.

Результат: отключаемый по желанию режим размышления на Gemma 4, очень комфортный режим работы.

По ходу возникла трудность с режимом памяти. Т.к. я использую очень маленькое окно контекста в 8192 токена для экономии памяти, модель очень быстро забывает, о чем мы с ней общаемся. Но я решил это через MCP Servers и скрипт, который делает автоматическую выгрузку истории чатов Unsloth в отдельную базу памяти.

Как это работает:

Unsloth хранит все чаты в собственной SQLite-базе (studio.db). Этот скрипт раз в несколько секунд копирует оттуда сообщения во ВТОРУЮ базу (memory.db), которая лежит вне песочницы чата. Модель подключается к memory.db через MCP-сервер sqlite-memory и может читать историю из любого нового чата.

ГЛАВНОЕ ПРЕИМУЩЕСТВО: запись делает скрипт, а не модель. Ноль токенов в окне, тексты дословные, модель не может «забыть» сохранить.

Что делает скрипт:

  • база Unsloth открывается ТОЛЬКО НА ЧТЕНИЕ, поэтому скрипт Unsloth не мешает;

  • новые сообщения добавляются, измененные (редактирование, регенерация) обновляются;

  • сообщения, удаленные в Unsloth, в архиве ОСТАЮТСЯ (это архив, а не зеркало);

  • дублей не бывает: у каждого сообщения уникальный src_id;

  • всё пишется в sync.log рядом с memory.db (при pythonw консоли нет);

  • после каждой синхронизации с изменениями файл conversation_history.txt (рядом с memory.db) пересобирается из архива: вся история в сыром виде, по чатам, которую можно открыть в Блокноте.

Скриптом готов буду поделиться по личному запросу.

В следующей части я расскажу, сколько токенов мне удалось получить в режиме 16 GB ОЗУ + 16 GB GPU RAM, и да — это работает! Т.ч. покупка GPD Win Mini (2025) AMD AI 370, 32 GB / 2 TB вполне оправдана, и мои опасения, что комбинация 16+16 окажется нежизнеспособна, не подтвердились.

первая часть

вторая часть

четвертая часть

Мобильный, приватный, умный искусственный интеллект без цензуры, без интернета в твоей сумке — часть 2

Продолжаем исследования MOE моделей

Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M

Мобильный, приватный, умный искусственный интеллект без цензуры, без интернета в твоей сумке

первая часть

третья часть

четвертая часть

Игровая приставка: Lenovo Legion Go 2 Extreme (8ASP2), 32 GB RAM (с возможностью выделить 24 GB RAM под GPU)  в режиме 24 Gb под GPU/ 8 GB ОЗУ + Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M — 17.2 GB (18,556,685,440 bytes) — результат ~34 токена в секунду 

modefile:

FROM ./Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf
# Полная разгрузка на GPU
PARAMETER num_gpu 99
# Безопасный размер контекста для предотвращения переполнения
PARAMETER num_ctx 8192
# Ограничение числа потоков CPU (предотвращает ошибку thread constructor failed)
PARAMETER num_thread 4
# Параметры генерации
PARAMETER temperature 0.7
PARAMETER top_p 0.8
PARAMETER top_k 20
PARAMETER min_p 0.0
PARAMETER presence_penalty 0.0
PARAMETER repeat_penalty 1.05
TEMPLATE """{{ if .System }}<|im_start|>system
{{ .System }}<|im_end|>
{{ end }}{{ if .Prompt }}<|im_start|>user
{{ .Prompt }}<|im_end|>
{{ end }}<|im_start|>assistant
{{ .Response }}<|im_end|>
"""
SYSTEM """You are a helpful, respectful, and honest assistant."""

ollama run Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Лос-Анджелес» —verbose

total duration: 1m18.554888s
load duration: 29.7978967s
prompt eval count: 21 token(s)
prompt eval duration: 268.495ms
prompt eval rate: 78.21 tokens/s
eval count: 1657 token(s)
eval duration: 48.46864s
eval rate: 34.19 tokens/s

ollama run Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Нью-Йорк» —verbose

total duration: 1m20.6209218s
load duration: 29.8590522s
prompt eval count: 19 token(s)
prompt eval duration: 260.529ms
prompt eval rate: 72.93 tokens/s
eval count: 1719 token(s)
eval duration: 50.485625s
eval rate: 34.05 tokens/s

ollama run Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Сан-Франциско» —verbose

total duration: 58.5064647s
load duration: 14.1386756s
prompt eval count: 20 token(s)
prompt eval duration: 312.77ms
prompt eval rate: 63.94 tokens/s
eval count: 1522 token(s)
eval duration: 44.038927s
eval rate: 34.56 tokens/s

Нюанс редакции Qwen3-30B-A3B-Instruct-2507-Heretic — по умолчанию отключен режим предварительного размышления и 3,3 миллиарда активных параметров, соответственно приятная скорость, но расход ресурсов уже больше:

нагрузка на GPU те же 93% что и Gemma4 26B MoE -Q4-K-M  Heretic  в вот памяти GPU занимает  уже 87%  против 72% на Gemma

По ОЗУ в это раз я выгрузил Duck Duck go из памяти,  по ощущениям сама операционная система уже на грани,  чувствуется свап, нужно снижать окно контента.

А еще я нашел очень интересную оболочку Unsloth Desktop как авторы ее называют «The first desktop app to run and train AI models». Она  мне показалась гораздо стабильнее open WebUi

первая часть

третья часть

четвертая часть

Мобильный, приватный, умный искусственный интеллект без цензуры, без интернета в твоей сумке.

Мобильный, приватный, умный искусственный интеллект без цензуры, без интернета в твоей сумке.

Можно ли получить все это за вменяемые деньги, точнее до 2000 USD? Ответ: да, я протестировал, и это работает. Коротко, в нескольких словах, без воды:

Игровая приставка: Lenovo Legion Go 2 Extreme (8ASP2), 32 GB RAM (с возможностью выделить 24 GB RAM под GPU) + gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf 15.6 GB (16,796,011,680 bytes)  в редакции Heretic  ~24 токена в секунду

В принципе, на этом можно и закончить, но на этот раз сделаю исключение и напишу более подробную статью. Все нижеописанное является моим субъективным мнением; если есть решение лучше — можете мне о нем написать.

Есть задача: получить мобильный, персональный, приватный и главное — умный искусственный интеллект без цензуры, не зависящий от интернета, в качестве персонального ИИ-ассистента, в гуманном бюджете с учетом текущих цен на оперативную память.

Модели на 3–6–9–12B мне не интересны:

По моему личному мнению, эти модели хороши как чат-боты, но не как умные компаньоны.

Для меня  интеллект начинается с 26–32 миллиардов параметров.

Даже при разделении на экспертов в MOE ~ по 4B параметров , 26B MOE  умнее и глубже, чем 12B. + MOE модель меньше подвержена глюцинациям + прирост производительности очень существенный.

Ближайшее интересное решение — очень компактный ноутбук GPD Win Mini (2025) AMD AI 370, 32 GB / 2 TB + есть встроенный NPU-чип, способный потенциально взять на себя обработку распознавания и генерации речи. Но меня остановили следующие нюансы:

  • нет подтверждения информации о возможности выделить под GPU больше 16 GB RAM из-за особенностей BIOS;

  • стоимость доставки из-за границы с рисками повреждений, отсутствие гарантии и трудности с возвратом;

  • окончательная стоимость у меня в стране — 2400 USD

Я нашел более изящное решение: Lenovo Legion Go 2 Extreme, 32 GB RAM, гарантированная возможность выделить 24 GB под GPU, соответственно — больше места под кэш и контекстное окно, более умные модели с нормальным квантованием без сильной потери качества. Если бы у меня не пошел ИИ, я всегда получаю игрушку для AAA-проектов + 3 года гарантии. Итого цена решения — 1900 USD.

вот результаты моих тестов :

настройки modefile:

# Указываем базовую GGUF-модель (путь может быть абсолютным или относительным, где лежит файл)
FROM ./gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf

# Твои параметры
PARAMETER num_ctx 8192
PARAMETER flash_attention true
PARAMETER temperature 0.7
PARAMETER top_p 0.9
PARAMETER repeat_penalty 1.1

# Шаблон чата для корректной работы Gemma (в стиле ChatML / Gemma)
TEMPLATE """{{ if .System }}{{ .System }}{{ end }}{{ if .Prompt }}<start_of_turn>user
{{ .Prompt }}<end_of_turn>
{{ end }}<start_of_turn>model
{{ .Response }}<end_of_turn>"""

# Системный промпт по умолчанию (при необходимости можешь изменить)
SYSTEM """You are a helpful, respectful, and honest assistant."""

(Окно контента целенаправлено урезанно до 8192 чтобы не терять скорость и иметь резерв памяти)

конфигурация: 

Без нагрузки:

В момент рассуждений:

тесты и результаты:

ollama run gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи про Лос-Анджелес» —verbose

total duration: 1m23.0339404s
load duration: 15.170647s
prompt eval count: 26 token(s)
prompt eval duration: 322.618ms
prompt eval rate: 80.59 tokens/s
eval count: 1649 token(s)
eval duration: 1m7.527462s
eval rate: 24.42 tokens/s

ollama run gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи Нью-Йорк» —verbose

total duration: 1m25.8860327s
load duration: 14.877167s
prompt eval count: 23 token(s)
prompt eval duration: 330.67ms
prompt eval rate: 69.56 tokens/s
eval count: 1730 token(s)
eval duration: 1m10.67053s
eval rate: 24.48 tokens/s

ollama run gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи про Сан-Франциско» —verbose

total duration: 1m21.1723763s
load duration: 14.3842813s
prompt eval count: 25 token(s)
prompt eval duration: 356.556ms
prompt eval rate: 70.12 tokens/s
eval count: 1630 token(s)
eval duration: 1m6.398297s
eval rate: 24.55 tokens/s

на сколько 24 токена это быстро, можно посмотреть в этом ролике, но важный момент — скорость просела на ~1 токен из-за записи экрана, т.к выросла нагрузка на GPU (я записывал несколько дублей видео,  каждый раз был тот же результат — без включенной записи ~24 при включенной ~23 токена в секунду)

Для чистоты эксперимента, Ollama была выгружена из памяти и запуск производился с нуля

если средняя скорость чтения человеком  4-6 токенов в секунду, то 24 токена это комфортный вывод информации, при подключении WebUI скорость просядет еще ~ до 20 токенов в секунду, перспективность использования этого интерфейса продолжаю изучать, но пока он мне не нравится, по ощущениям — комфорт, отклик и скорость.

а вот с плотными моделями совсем другая история:

gemma-4-12B-it-heretic-Q4_K_M — 6.87 GB (7,381,381,760 bytes) — 10,8 токенов в секунду

Test:

ollama run gemma-4-12-q4_k_m:latest «расскажи про Лос-Анджелес» —verbose
total duration: 2m31.254414s
load duration: 9.5004932s
prompt eval count: 26 token(s)
prompt eval duration: 373.181ms
prompt eval rate: 69.67 tokens/s
eval count: 1532 token(s)
eval duration: 2m21.366823s
eval rate: 10.84 tokens/s

ollama run gemma-4-12-q4_k_m:latest «расскажи про Нью-Йорк» —verbose
total duration: 2m48.869715s
load duration: 8.9020887s
prompt eval count: 24 token(s)
prompt eval duration: 379.76ms
prompt eval rate: 63.20 tokens/s
eval count: 1725 token(s)
eval duration: 2m39.574522s
eval rate: 10.81 tokens/s

ollama run gemma-4-12-q4_k_m:latest «расскажи про Сан-Франциско» —verbose
total duration: 2m35.6647302s
load duration: 8.5794998s
prompt eval count: 25 token(s)
prompt eval duration: 358.514ms
prompt eval rate: 69.73 tokens/s
eval count: 1587 token(s)
eval duration: 2m26.717725s
eval rate: 10.82 tokens/s

Более четкая по размышлениям модель, с меньшим сжатием gemma4-12B-q8-clean — 11.7 GB (12,669,645,440 bytes) — всего 6,8 токенов в секунду

ollama run gemma-4-12b-q8-clean:latest «расскажи про Лос-Анджелес» —verbose
total duration: 4m6.0714634s
load duration: 12.6505637s
prompt eval count: 26 token(s)
prompt eval duration: 684.62ms
prompt eval rate: 37.98 tokens/s
eval count: 1597 token(s)
eval duration: 3m52.728304s
eval rate: 6.86 tokens/s
ollama run gemma-4-12b-q8-clean:latest «расскажи про Нью-Йорк» —verbose

total duration: 3m44.4679233s
load duration: 12.6456274s
prompt eval count: 24 token(s)
prompt eval duration: 676.542ms
prompt eval rate: 35.47 tokens/s
eval count: 1455 token(s)
eval duration: 3m31.137135s
eval rate: 6.89 tokens/s
ollama run gemma-4-12b-q8-clean:latest «расскажи про Сан-Франциско» —verbose

total duration: 4m21.9274252s
load duration: 12.8964248s
prompt eval count: 25 token(s)
prompt eval duration: 675.425ms
prompt eval rate: 37.01 tokens/s
eval count: 1708 token(s)
eval duration: 4m8.342528s
eval rate: 6.88 tokens/s

Вывод: плотная 12B модель прогоняет все свои веса за один токен, а 26MOE использует только часть нужных экспертов, поэтому более объемная и более умная модель 26MOE работает быстрее.

двигаемся дальше ….
Гипотеза  возможность голосового общения —> предполагается, что скорость генерации текста в 4–5 раз выше скорости (на MOE модели) с которой его может озвучить движок синтеза речи вроде Piper TTS

Но это не точно, эксперименты продолжаю……

вторая часть

третья часть

четвертая часть