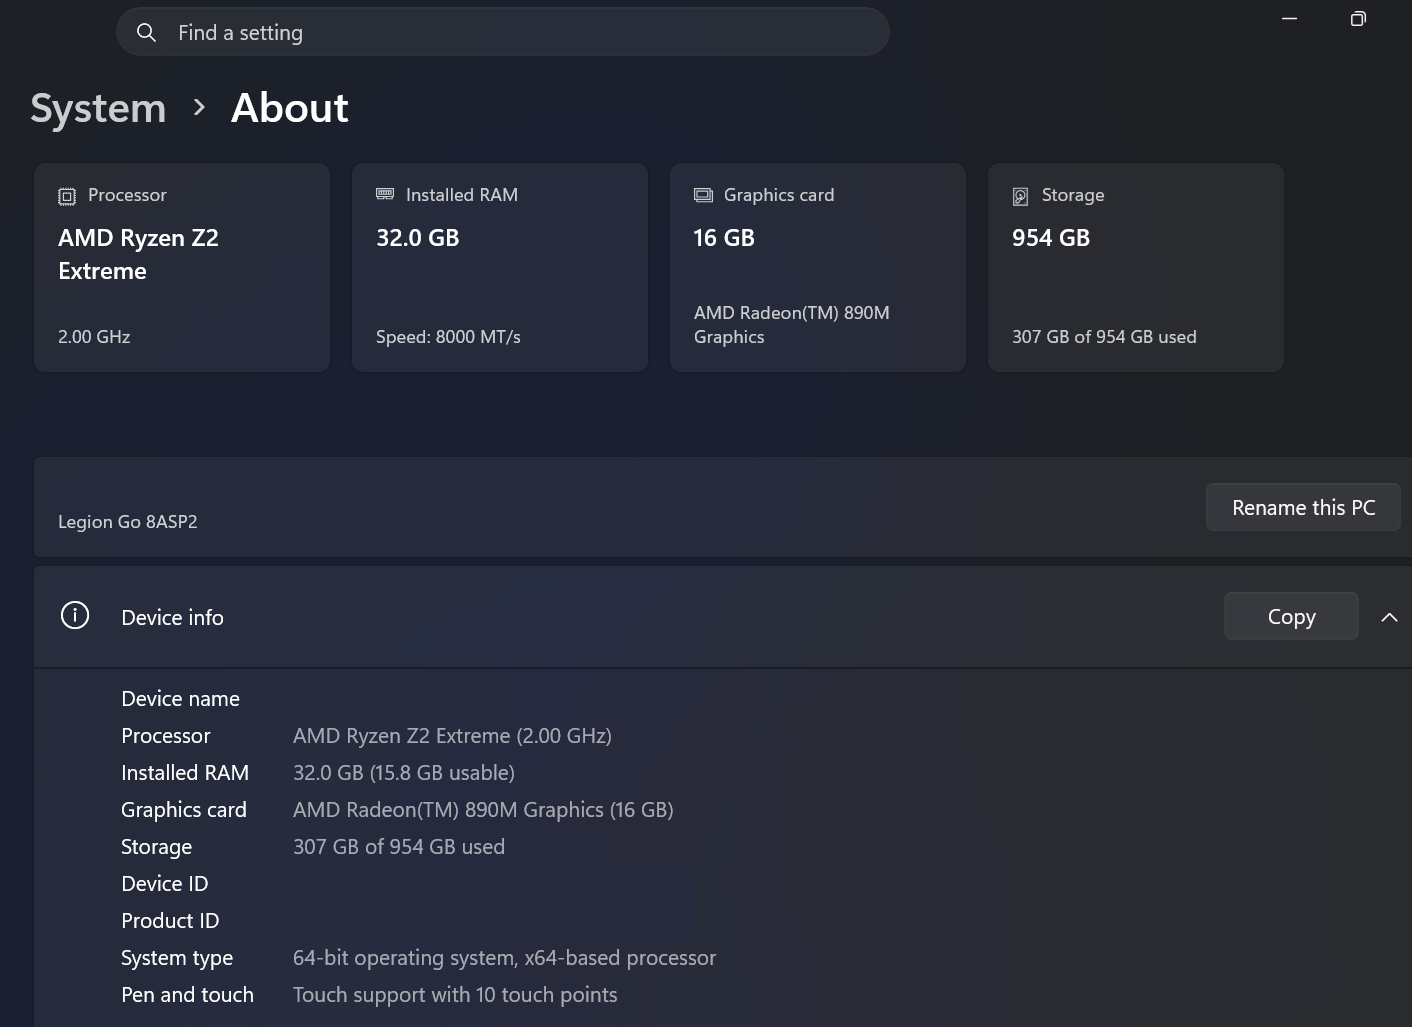
Продолжаю эксперименты с Legion Go 2 Extreme (8ASP2), 32 GB RAM в качестве мобильного, приватного, умного искусственного интеллекта без цензуры.
Режим 16 GB ОЗУ + 16 GB GPU
Условия самого теста не изменились, но обновилась Ollama — теперь она более требовательна к ключам запуска.
Режим 16+16 GB RAM
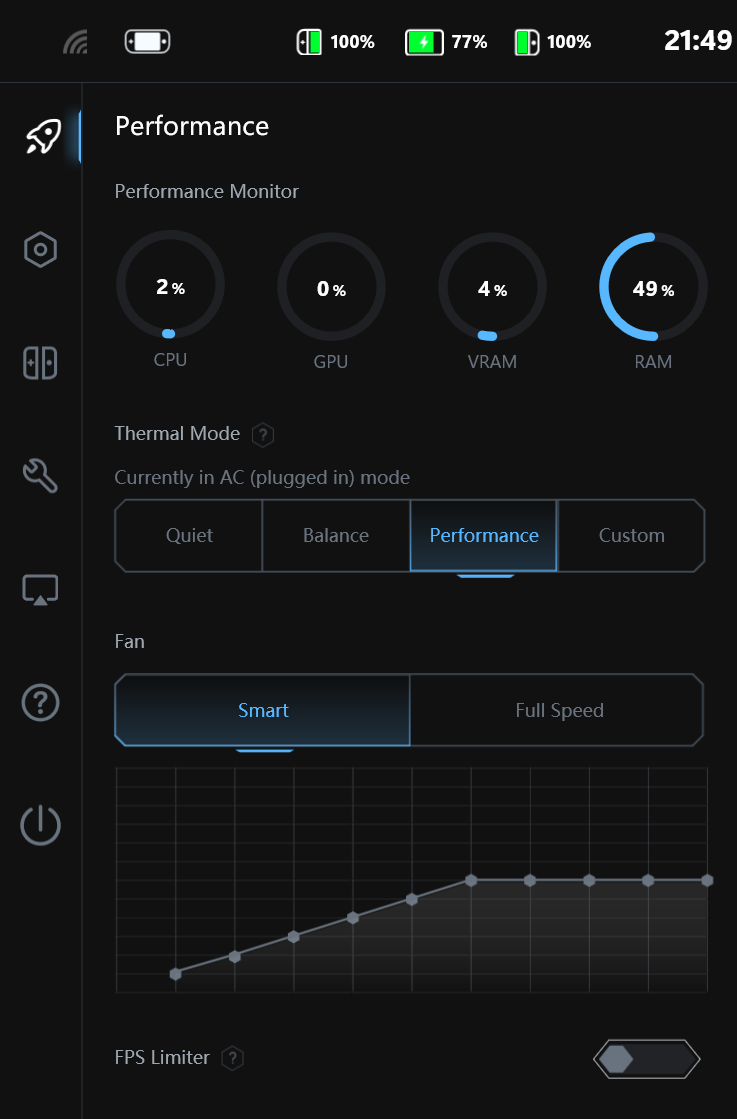
Система в режиме ожидания:
т.к. модель не помещается сейчас полностью в GPU, дополнительные приложения, кроме Notepad, выгружены из памяти.
Gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf 15.6 GB (16,796,011,680 bytes)
Modefile:
# Указываем базовую GGUF-модель (путь может быть абсолютным или относительным, где лежит файл)
FROM ./gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf

# Твои параметры
PARAMETER num_ctx 8192
PARAMETER flash_attention true
PARAMETER temperature 0.7
PARAMETER top_p 0.9
PARAMETER repeat_penalty 1.1

# Шаблон чата для корректной работы Gemma (в стиле ChatML / Gemma)
TEMPLATE """{{ if .System }}{{ .System }}{{ end }}{{ if .Prompt }}user
{{ .Prompt }}
{{ end }}model
{{ .Response }}"""

# Системный промпт по умолчанию (при необходимости можешь изменить)
SYSTEM """You are a helpful, respectful, and honest assistant."""
Режим thinking не получается отключить на уровне Ollama.
Тест:
ollama run —verbose gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи про Лос-Анджелес»
total duration: 1m43.6769527s
load duration: 16.4091987s
prompt eval count: 28 token(s)
prompt eval duration: 354.333ms
prompt eval rate: 79.02 tokens/s
eval count: 1659 token(s)
eval duration: 1m26.902626s
eval rate: 19.09 tokens/s
ollama run —verbose gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи Нью-Йорк»
total duration: 1m52.1386793s
load duration: 15.6352939s
prompt eval count: 25 token(s)
prompt eval duration: 302.903ms
prompt eval rate: 82.53 tokens/s
eval count: 1805 token(s)
eval duration: 1m36.189017s
eval rate: 18.77 tokens/s
ollama run —verbose gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf:latest «расскажи про Сан-Франциско»
total duration: 1m49.557638s
load duration: 15.6424668s
prompt eval count: 27 token(s)
prompt eval duration: 311.346ms
prompt eval rate: 86.72 tokens/s
eval count: 1779 token(s)
eval duration: 1m33.592024s
eval rate: 19.01 tokens/s
Нагрузка на систему: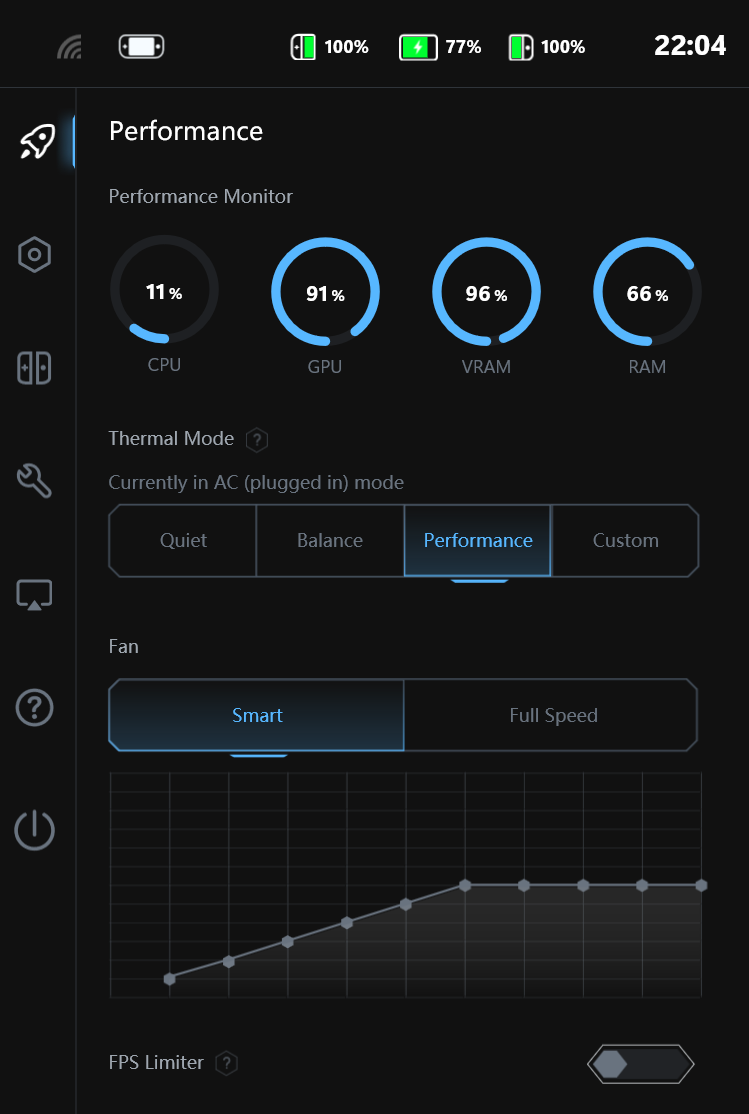
Результат 18–19 токенов за счет офлоуда против 24 токенов на 24 GB RAM: мы потеряли 5–6 токенов, но 18–19 токенов все равно остаются комфортным режимом для общения.
Переходим к тесту Qwen3-30B-A3B
Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf 17.2 GB (18,556,685,440 bytes)
Modefile:
FROM ./Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf
# Полная разгрузка на GPU
PARAMETER num_gpu 99
# Безопасный размер контекста для предотвращения переполнения
PARAMETER num_ctx 8192
# Ограничение числа потоков CPU (предотвращает ошибку thread constructor failed)
PARAMETER num_thread 4
# Параметры генерации
PARAMETER temperature 0.7
PARAMETER top_p 0.8
PARAMETER top_k 20
PARAMETER min_p 0.0
PARAMETER presence_penalty 0.0
PARAMETER repeat_penalty 1.05
TEMPLATE """{{ if .System }}<|im_start|>system
{{ .System }}<|im_end|>
{{ end }}{{ if .Prompt }}<|im_start|>user
{{ .Prompt }}<|im_end|>
{{ end }}<|im_start|>assistant
{{ .Response }}<|im_end|>
"""
SYSTEM """You are a helpful, respectful, and honest assistant."""
Режим thinking отключен.
Ollama run —verbose Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Лос-Анджелес»
total duration: 1m16.5946761s
load duration: 16.3385718s
prompt eval count: 23 token(s)
prompt eval duration: 263.35ms
prompt eval rate: 87.34 tokens/s
eval count: 1523 token(s)
eval duration: 59.980869s
eval rate: 25.39 tokens/s
ollama run —verbose Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Нью-Йорк»
total duration: 1m9.9386374s
load duration: 16.1066431s
prompt eval count: 21 token(s)
prompt eval duration: 232.669ms
prompt eval rate: 90.26 tokens/s
eval count: 1338 token(s)
eval duration: 53.591474s
eval rate: 24.97 tokens/s
ollama run —verbose Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Сан-Франциско»
total duration: 1m17.2677307s
load duration: 15.8550492s
prompt eval count: 22 token(s)
prompt eval duration: 250.865ms
prompt eval rate: 87.70 tokens/s
eval count: 1504 token(s)
eval duration: 1m1.156034s
eval rate: 24.59 tokens/s
Нагрузка на систему:
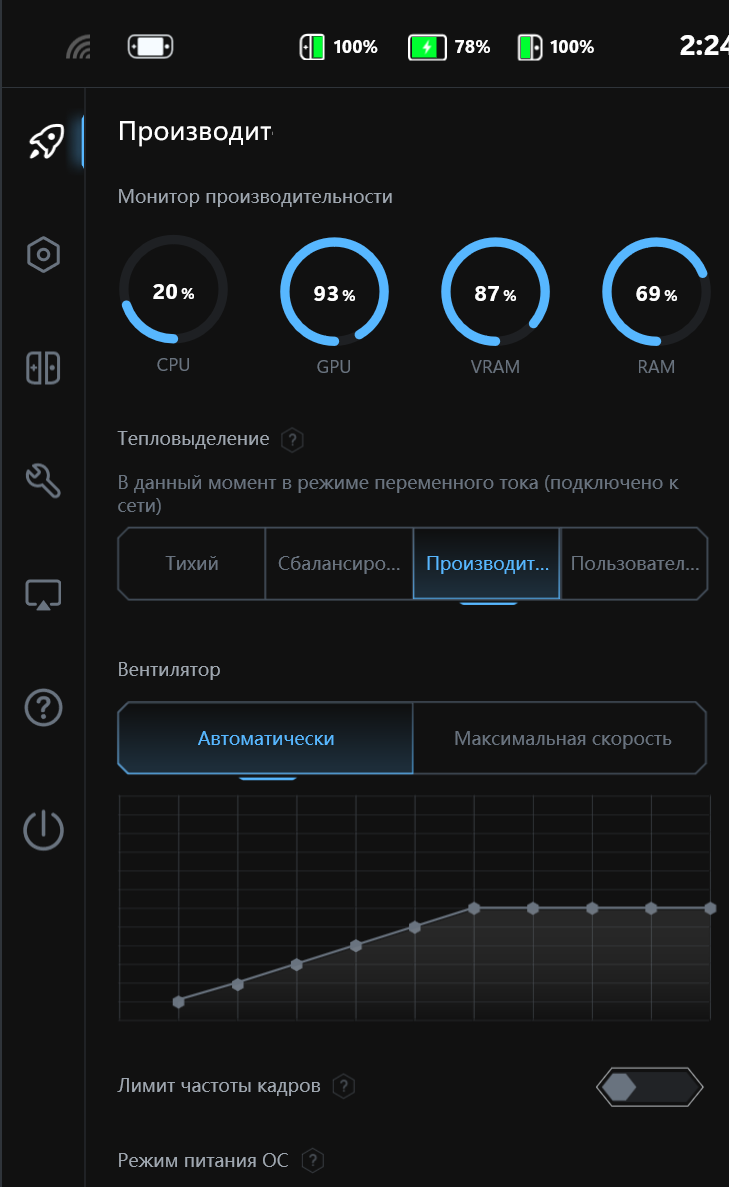
Результат 24–25 токенов против 34 токенов на 24 GB RAM, потери 9–10 токенов на офлоуде, но стабильность системы, а точнее самой Windows, значительно выросла, ощущения тормозов больше нет.
Нагрузка на GPU-память у Qwen3-30B-A3B меньше, чем у Gemma-4-26B-A4B, т. к. у Qwen 3,3 млрд активных параметров на один токен против 3,8–4 млрд у Gemma 4.
Боевой тест, применение в реальности
Переходим на Unsloth — здесь все гораздо интереснее.
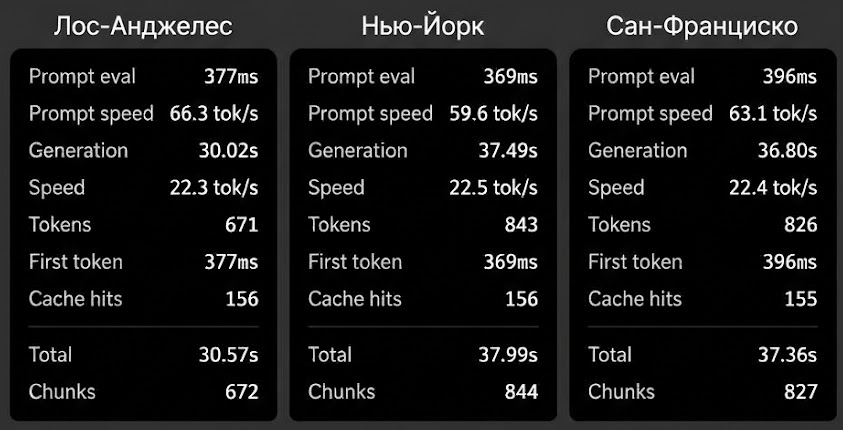
Условия: все приложения, кроме Unsloth и Notepad, выгружены.
Окно контекста — 8192 токена, режим thinking выключен.
Gemma-4-26B-A4B-it-heretic.Q4_K_M.gguf 15.6 GB (16,796,011,680 bytes)
Каждый запрос — в новом окне чата.
Надо отметить, что ответы в Unsloth стали короче, но при этом я отмечаю поразительно низкий разброс результатов: в среднем 22 токена против 24 на живой Ollama с 24 GB GPU RAM.
Следующий тест:
Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf 17.2 GB (18,556,685,440 bytes)
Каждый запрос — в новом окне чата.
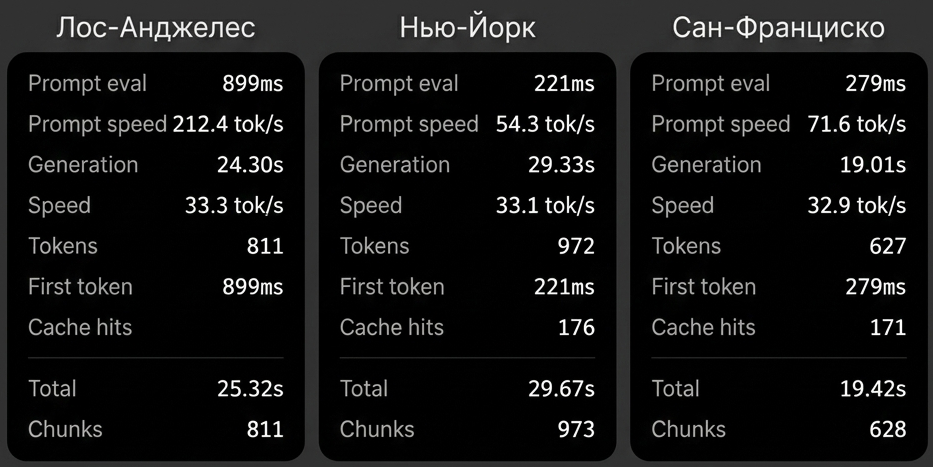
Здесь результат 32–33 токена против 34 на Ollama с 24 GB GPU RAM.
Мой вывод: режим 16 + 16 GB позволяет комфортно запускать тяжелые MoE-модели Gemma-4-26B-A4B и Qwen3-30B-A3B на Legion Go 2 Extreme (8ASP2), 32 GB RAM с офлоудом в ОЗУ. Стабильность операционной системы Windows 11 при работе с моделями в режиме 16 GB ОЗУ намного лучше, чем в режиме 24 GB GPU + 8 GB ОЗУ. Unsloth — очень интересная оболочка.
Остается открытым вопрос с голосовой озвучкой: встроенные голоса Microsoft ужасны, Piper дает результат лучше, но все равно режет слух.
На хороший голос нужно выделить независимую голосовую ИИ-модель, но здесь начинается драка между моделями за память в GPU. На ОЗУ, даже если ее удастся втиснуть между системой и офлоудом модели, скорость будет ужасная.
В режиме 16+16 свободной памяти GPU практически нет, рисковать буфером и менять мозги на голос я точно не буду. В режиме 8+24 можно, конечно, будет попробовать, но пока моя конфигурация:
Gemma-4-26B-A4B — основная модель + Qwen3-30B-A3B как второе мнение , остается без голоса