Продолжаем исследования MOE моделей
Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M
Мобильный, приватный, умный искусственный интеллект без цензуры, без интернета в твоей сумке
Игровая приставка: Lenovo Legion Go 2 Extreme (8ASP2), 32 GB RAM (с возможностью выделить 24 GB RAM под GPU) в режиме 24 Gb под GPU/ 8 GB ОЗУ + Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M — 17.2 GB (18,556,685,440 bytes) — результат ~34 токена в секунду
modefile:
FROM ./Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf
# Полная разгрузка на GPU
PARAMETER num_gpu 99
# Безопасный размер контекста для предотвращения переполнения
PARAMETER num_ctx 8192
# Ограничение числа потоков CPU (предотвращает ошибку thread constructor failed)
PARAMETER num_thread 4
# Параметры генерации
PARAMETER temperature 0.7
PARAMETER top_p 0.8
PARAMETER top_k 20
PARAMETER min_p 0.0
PARAMETER presence_penalty 0.0
PARAMETER repeat_penalty 1.05
TEMPLATE """{{ if .System }}<|im_start|>system
{{ .System }}<|im_end|>
{{ end }}{{ if .Prompt }}<|im_start|>user
{{ .Prompt }}<|im_end|>
{{ end }}<|im_start|>assistant
{{ .Response }}<|im_end|>
"""
SYSTEM """You are a helpful, respectful, and honest assistant."""
ollama run Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Лос-Анджелес» —verbose
total duration: 1m18.554888s
load duration: 29.7978967s
prompt eval count: 21 token(s)
prompt eval duration: 268.495ms
prompt eval rate: 78.21 tokens/s
eval count: 1657 token(s)
eval duration: 48.46864s
eval rate: 34.19 tokens/s
ollama run Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Нью-Йорк» —verbose
total duration: 1m20.6209218s
load duration: 29.8590522s
prompt eval count: 19 token(s)
prompt eval duration: 260.529ms
prompt eval rate: 72.93 tokens/s
eval count: 1719 token(s)
eval duration: 50.485625s
eval rate: 34.05 tokens/s
ollama run Qwen3-30B-A3B-Instruct-2507-Heretic.Q4_K_M.gguf:latest «Расскажи про Сан-Франциско» —verbose
total duration: 58.5064647s
load duration: 14.1386756s
prompt eval count: 20 token(s)
prompt eval duration: 312.77ms
prompt eval rate: 63.94 tokens/s
eval count: 1522 token(s)
eval duration: 44.038927s
eval rate: 34.56 tokens/s
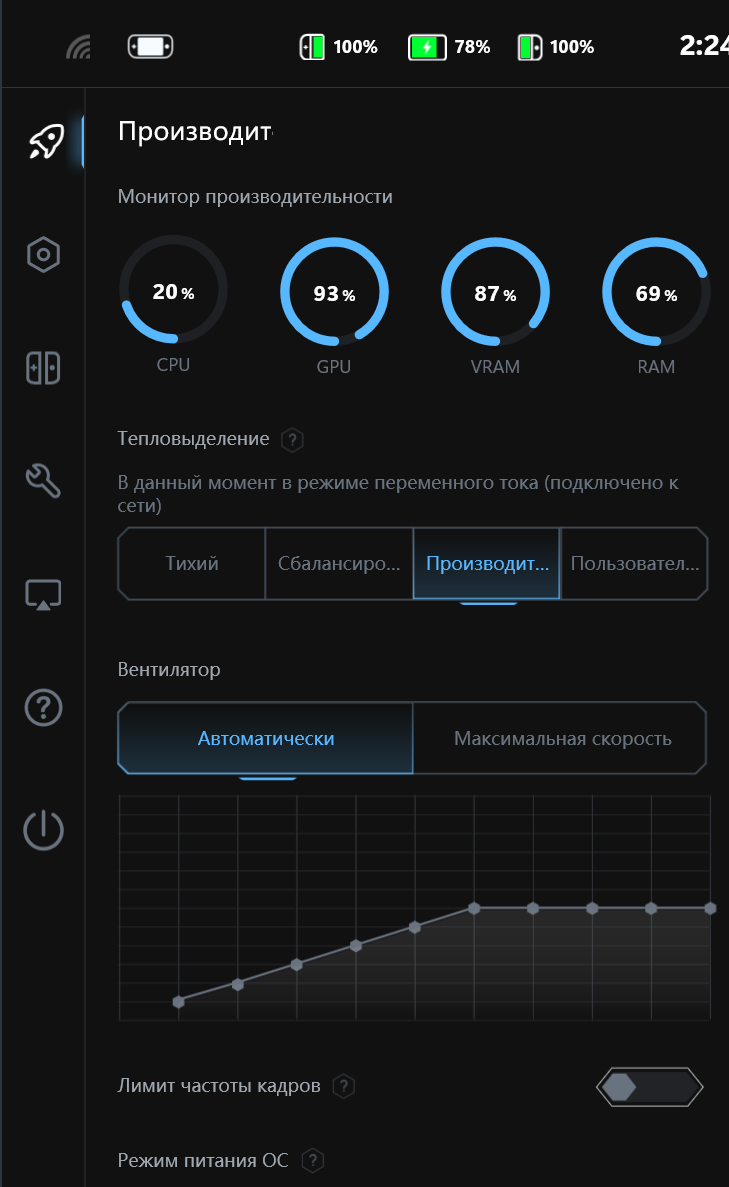
Нюанс редакции Qwen3-30B-A3B-Instruct-2507-Heretic — по умолчанию отключен режим предварительного размышления и 3,3 миллиарда активных параметров, соответственно приятная скорость, но расход ресурсов уже больше:
нагрузка на GPU те же 93% что и Gemma4 26B MoE -Q4-K-M Heretic в вот памяти GPU занимает уже 87% против 72% на Gemma
По ОЗУ в это раз я выгрузил Duck Duck go из памяти, по ощущениям сама операционная система уже на грани, чувствуется свап, нужно снижать окно контента.
А еще я нашел очень интересную оболочку Unsloth Desktop как авторы ее называют «The first desktop app to run and train AI models». Она мне показалась гораздо стабильнее open WebUi